
阶跃 StepAudio 3 发布:语音推理、实时对话双榜第一
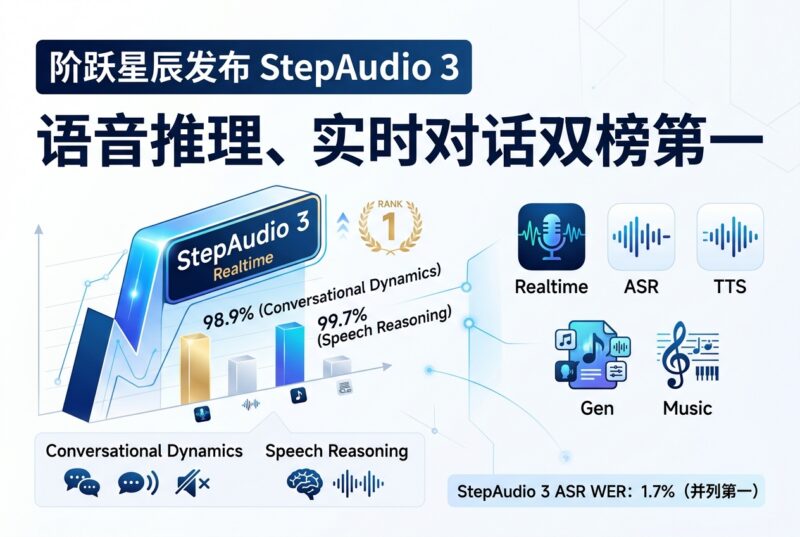
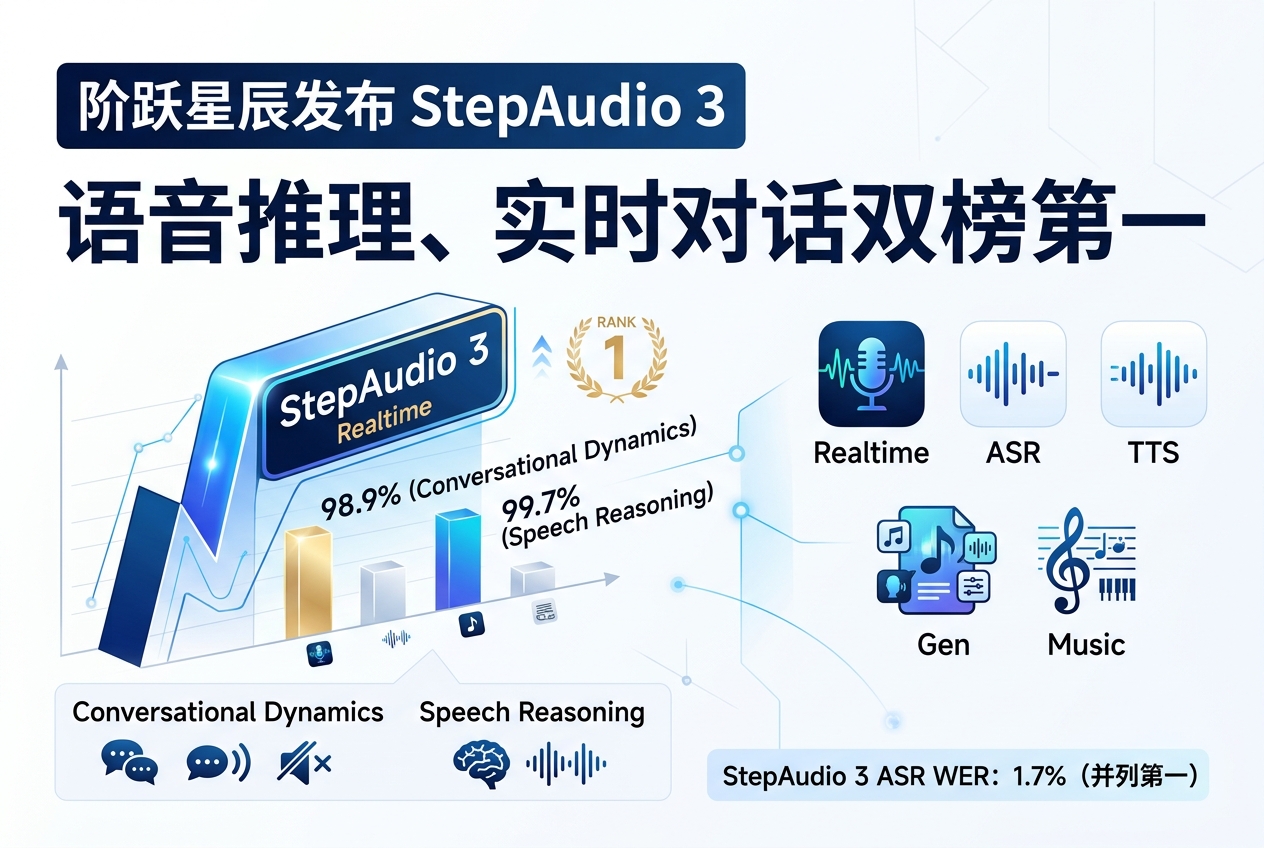
阶跃星辰发布 StepAudio 3,同时推出 Realtime、ASR、TTS、Gen 和 Music 五款语音模型。
在 Artificial Analysis 的两项语音评测中,StepAudio 3 Realtime 均排名第一。其中,Conversational Dynamics 得分为 98.9%,高于 Qwen Audio 3.0 Realtime Plus 的 98.4% 和 GPT-Realtime-2 High 的 95.3%;Speech Reasoning 得分为 99.7%,同样位列第一。
Conversational Dynamics 主要评估模型对停顿、轮流发言、用户打断以及“嗯”“对”等附和语的处理能力;Speech Reasoning 则评估模型直接理解音频并完成推理的能力。
在 Artificial Analysis 非流式语音识别榜单中,StepAudio 3 ASR 的词错误率(WER)为 1.7%,与 Fun-Realtime-ASR-preview 并列第一。
此外,StepAudio 3 Gen 支持一次生成包含人声、音效、环境声和音乐的音频,并根据场景进行统一编排。
目前,五款模型均已进入阶跃星辰的语音产品线。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END



暂无评论内容