
信息一改再改,大模型就乱了:表现最好的 GPT-5.5 也只能答对 59.3%
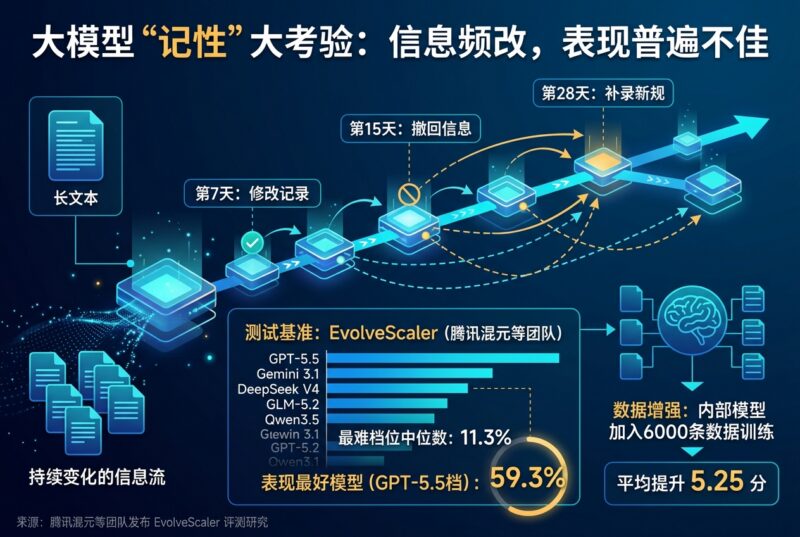
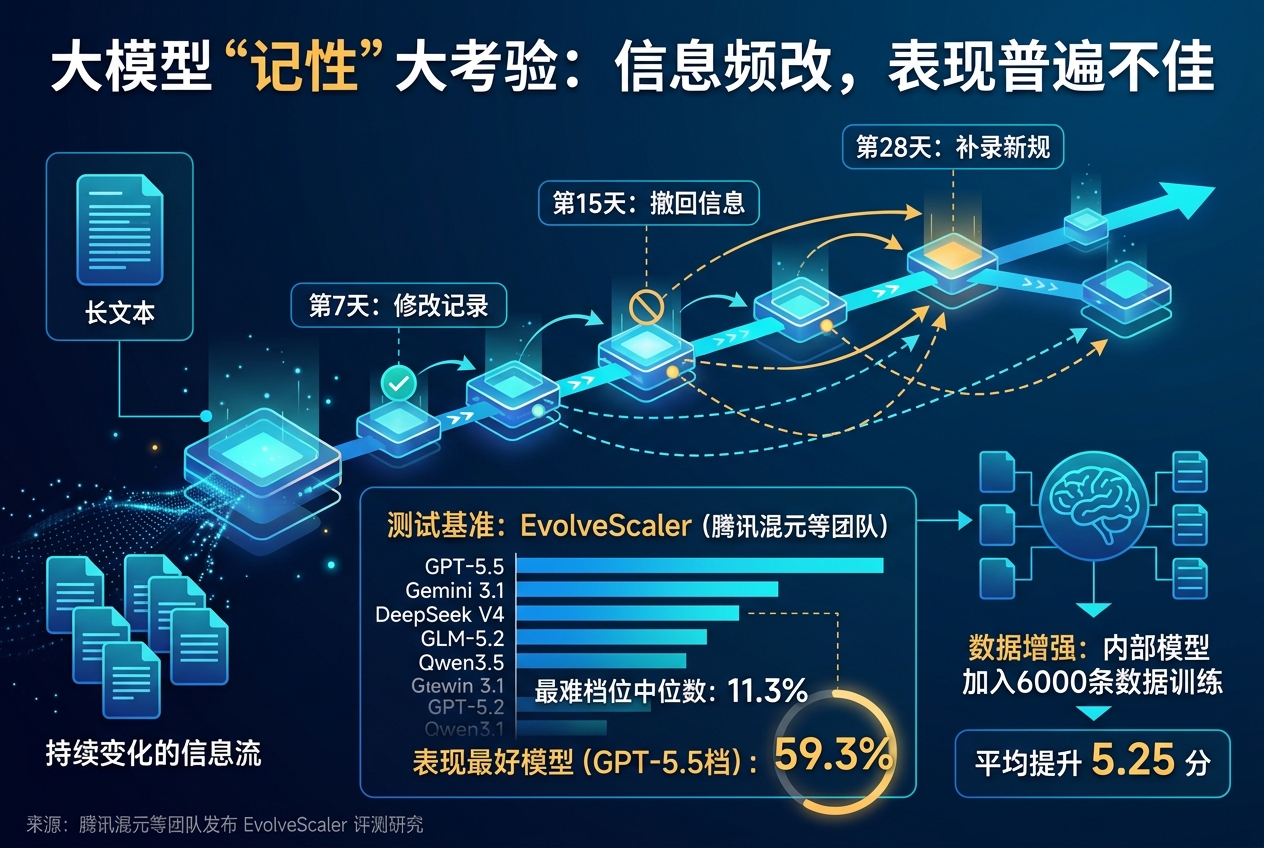
腾讯混元等团队发布了 EvolveScaler,专门测试大模型能否跟上不断变化的信息。该基准会在长文本中持续加入修改、撤回、补录和作废的信息,再要求模型根据最新状态回答问题。
例如,模型先看到一段持续 40 天的游戏记录,随后被问到:“如果第 7 天没有打那个小 Boss,最后还能不能获胜?”这一改变会连带影响后续的装备、血量和战斗结果。模型需要从第 7 天开始,根据新的条件重新推演之后几十天的进程,原文中并没有现成答案。
团队设计了 117 类任务和 159 种问题,最长约包含 1200 个事件。测试涉及 14 个模型配置,包括 GPT-5.5、Gemini 3.1 Pro、DeepSeek V4 Preview Pro、GLM-5.2 和 Qwen3.5 Plus。
在最难档位,模型成绩的中位数仅为 11.3%;表现最好的 GPT-5.5-xhigh 也只有 59.3%。
这套数据还可以用于训练模型。一个内部 A3B 模型加入 6000 条此类数据后,在 8 个外部测试中均取得提升,平均提高 5.25 分。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END



暂无评论内容