
又一条 RSI 路线:模型参数不变,Agent 依靠 Memory 持续改进
UCSD 助理教授黄碧薇创办的因果世界模型公司 Aether AI 开源了 RSIAgent。
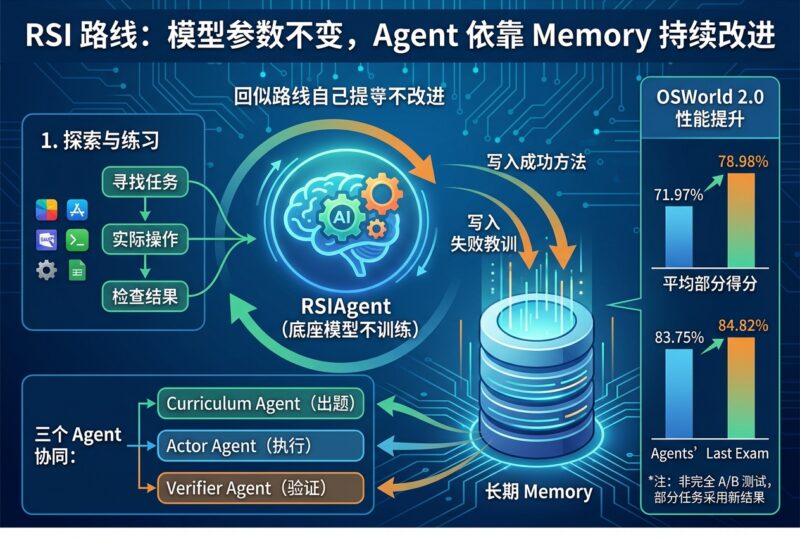
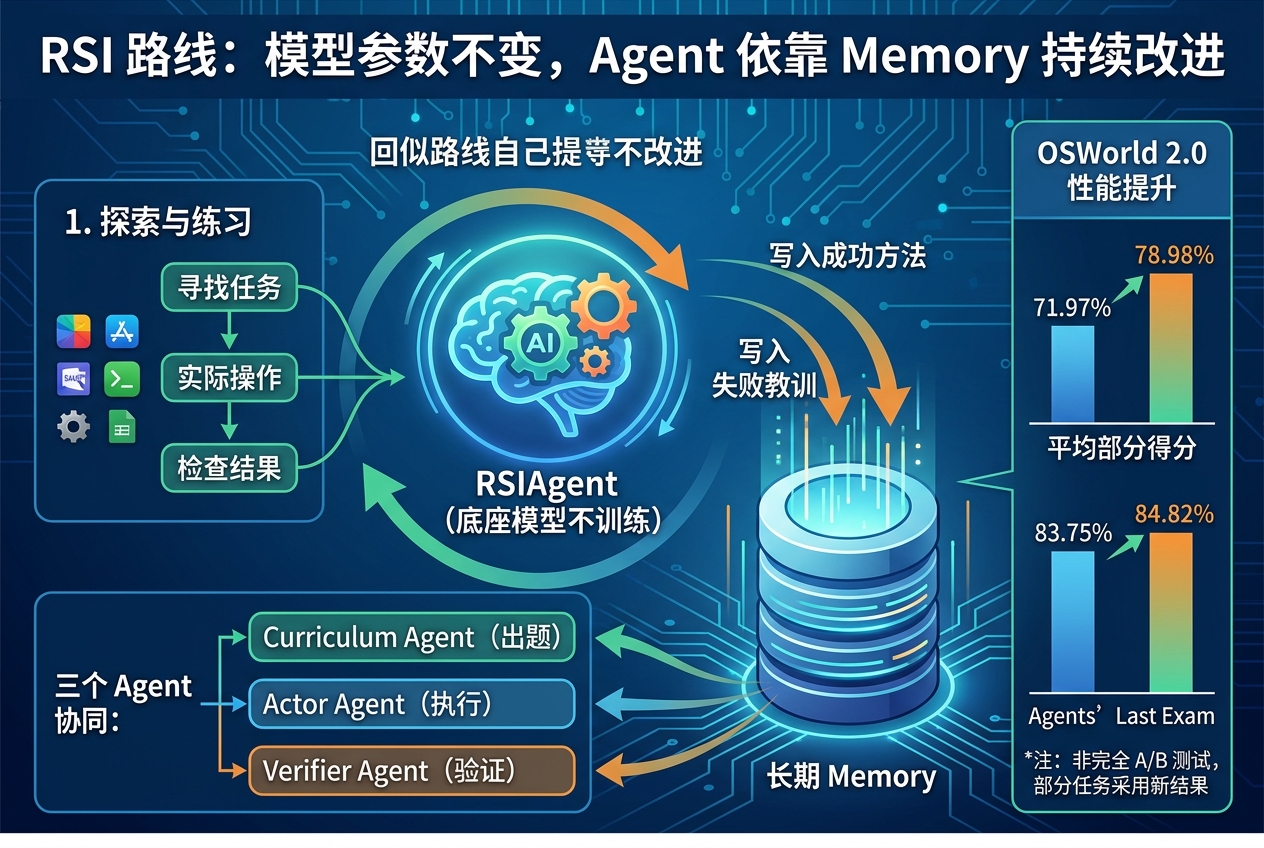
这是一套不训练模型的递归自我改进框架。底层模型参数始终保持不变,Agent 会自行寻找值得练习的任务,实际操作并检查结果,再将成功方法和失败教训写入长期 Memory。下一轮继续利用这些经验,逐步弥补能力短板。
系统由三个 Agent 协同完成:
Curriculum Agent 决定接下来练习什么;Actor Agent 负责实际操作软件;Verifier Agent 独立检查任务结果。
探索过程分为两步:首先广泛尝试不同任务,随后针对失败案例、隐藏限制和边界情况进行深入探索。最后,Memory 会被冻结,并直接用于执行正式任务。
在 OSWorld 2.0 上,加入这套 RSI 后,平均部分得分从 71.97% 提升至 78.98%;Agents’ Last Exam 得分从 83.75% 提升至 84.82%。
不过,这并不是整套测试的严格 A/B 对比。OSWorld 只有一半任务实际采用了加入 RSI 后的新结果,其余任务继续沿用原有成绩。
RSIAgent 与 Prime Agent 等 Harness 自我改进思路属于同一大方向:模型权重保持不变,持续更新模型之外的组件。RSIAgent 的特点是将改进重点放在 Memory 上,并通过自主出题与独立验证,让这套外部经验库持续积累。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END



暂无评论内容